火簇・AI 观察| 发稿量在涨,AI 采信没动:评估信源渠道的 3 个刻度
做工业检测设备这一行,市场部的季度复盘会上总会出现同一个画面。
投放报表很好看:本季度的稿件发布量、收录数、阅读量,条条往上走。会议快结束时有人顺手打开一个 AI 问答,把"工业检测设备怎么选"这句话打进去——AI 列出来的品牌和供应商里,没有自己。
会议室安静了两秒。有人问:是不是发得还不够多?
我的判断是:问题不在发得多不多,在这把尺子量不到该量的地方。
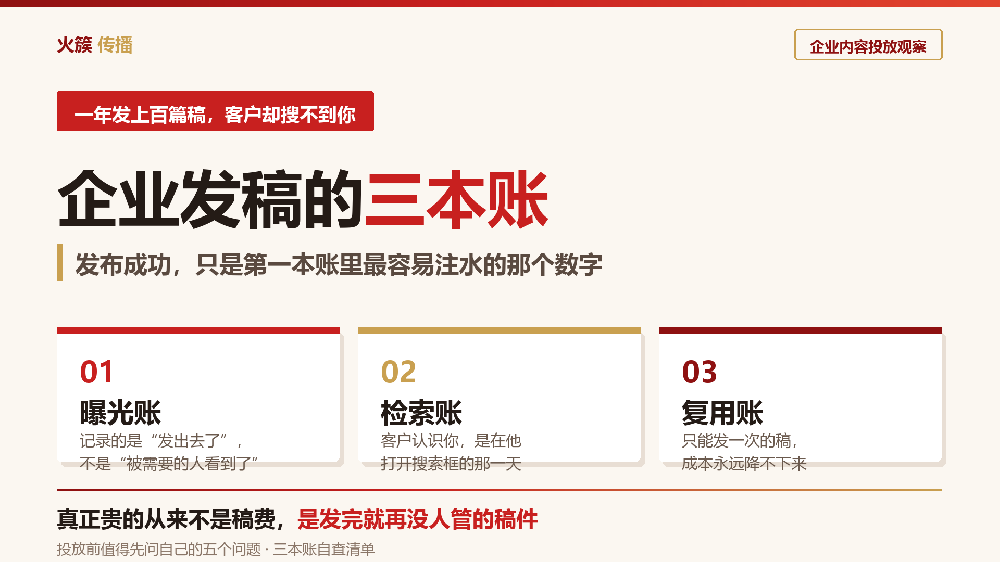
过去评估媒体发稿的那套口径,只覆盖了一次投放的前半程。
前半程是"发出去":选了多少家媒体、出了多少条链接、阅读量多少。后半程是"被采信":这些内容有没有进入大模型愿意引用的那部分语料。两件事中间,隔着一整套信源结构。
一、搜索的动作变了,答案里出现谁才是重点
先看三组公开数据。
中国互联网络信息中心 2025 年 10 月 18 日发布《生成式人工智能应用发展报告(2025)》。报告显示:截至 2025 年 6 月,我国生成式人工智能用户规模达 5.15 亿人,普及率 36.5%。
仅上半年,这个规模就增长了 2.66 亿人。报告还提到,把这套技术用于"回答问题"的用户占 80.9%。
用户的动作没变,还是提问题。变的是问题被回答的方式。
市场研究机构 Gartner 在 2024 年 2 月给出过一个判断:到 2026 年,传统搜索引擎的搜索量将下降 25%,搜索营销的份额会落在聊天机器人和虚拟代理之后。
同期另一组被反复引用的数据来自 SparkToro、Semrush 等机构对 2025 年的跟踪:美国市场的谷歌搜索中,约 58.5% 不产生对任何外部网站的点击;在出现 AI 摘要的查询里,这个比例更高。
三组数据指向同一处:
一次提问的终点,正在从"点开一个链接"变成"读完一段答案"。
这件事对 B2B 生意的份量比看起来重。工业检测设备这类采购,决策链长、单值高,买方在正式比价之前,心里通常已经把候选名单过了一遍。名单从哪里来?以前是搜索结果的首页,现在越来越多是 AI 给出的那一段回答。
答案里没有你,等于名单里没有你。
二、"发得出去"和"被采信",是两件事
不少企业把"发稿无效"的结论下得很快:钱花了、稿子发了、没询盘,所以渠道没用。
这个结论下得太急。
先分清两个动作。收录是搜索引擎的抓取动作,说明这条链接被看见了;采信是大模型生成回答时,把这条内容当作可信依据。链接被收录,不等于里面的内容会被引用。
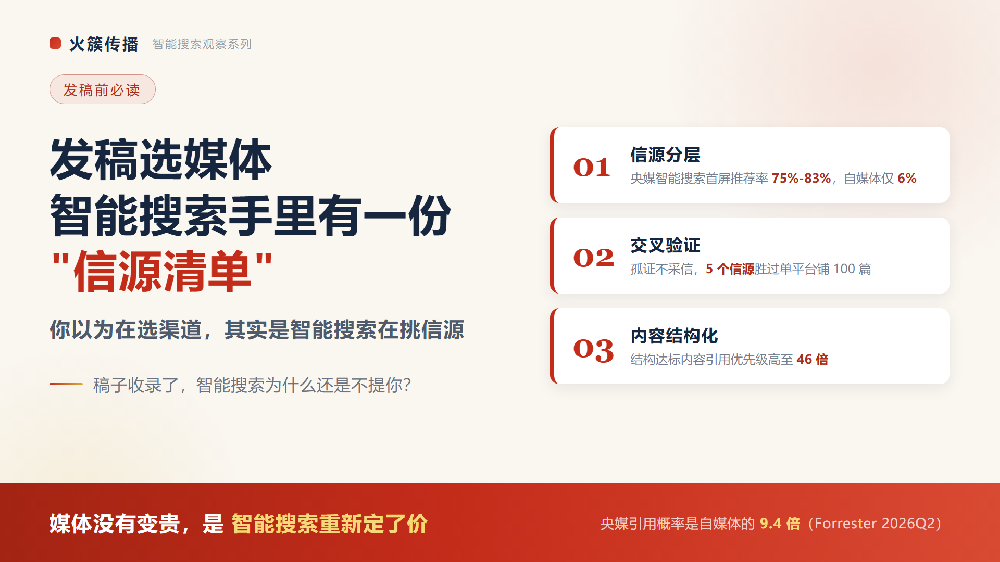
再看一层:媒体池不等于信源池。手里有多少条媒体资源,和这些资源里有多少能进入模型反复采信的范围,是两个数量级的问题。真正被采信的往往是其中一部分:有明确运营主体、有编辑环节、内容能被回溯到具体一方的那批。
反过来说,端口站、采集站、无主体的聚合页,发布成功率往往很高,价格也低。它们能交出一条链接,但在模型那一侧,几乎没什么份量。
有人会追问:那是不是只盯权威媒体就够了?
也不全是。权威度是其中一个维度,不是全部。
处理专业问题时,模型需要的是"能回答具体问题"的内容——一篇把某个技术参数讲清楚的行业稿,在特定提问下的价值,可能高于一篇泛泛的品牌新闻。这也解释了一件事:为什么有些企业明明上过大媒体,仍然没被提过。
三、三个刻度:把评估口径换掉
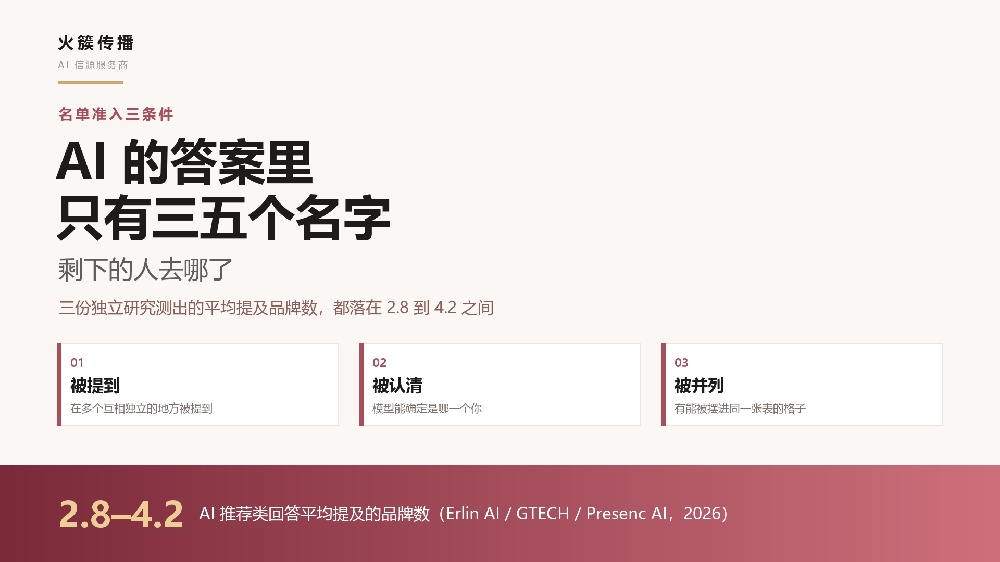
评估发稿渠道,我建议换成三个刻度来量。它们不复杂,但顺序不能颠倒。
刻度一、溯源刻度:这条渠道背后,有没有一个说得清的主体。
判断方式很朴素——内容谁在运营,稿件有没有人看过一遍再发,出了偏差能不能找到负责的一方。这三个问题答得上来,渠道才有资格进入下一步;答不上来的,无论单价多低,都属于一次性消耗。
刻度二、解析刻度:这篇稿子,机器读不读得懂。
大模型理解一段文字,靠的是里面的事实关系。谁、做了什么、指标是多少、在什么条件下成立——信息密度高的句子,机器容易接住。
反过来看,"以匠心铸就品质""致力于成为领先者"这类表达,人读着顺,机器读完提取不到任何可落地的事实。同样的预算,前者产出的是一条可以被引用的信息,后者产出的是一段占位文字。
刻度三、复现刻度:隔一段时间再问同样的问题,答案稳不稳。
单次被提及可能是偶然:也许恰好那天模型抓到了那条稿子,也许只是同类内容太少。稳定出现才算资产。
这个刻度有一个好处——它不需要额外投入,只需要一个记录动作:把品类相关的问题列出来,隔一个月再问一遍,看答案里有没有你、描述得准不准。这是一件成本很低的自查动作。
三个刻度的顺序是:先看渠道能不能被信任,再看内容能不能被读懂,最后才看结果能不能被复现。
跳过第一个直接看第三个,看到的多半是噪音。
四、四个坑
1、把发布量当成绩单。
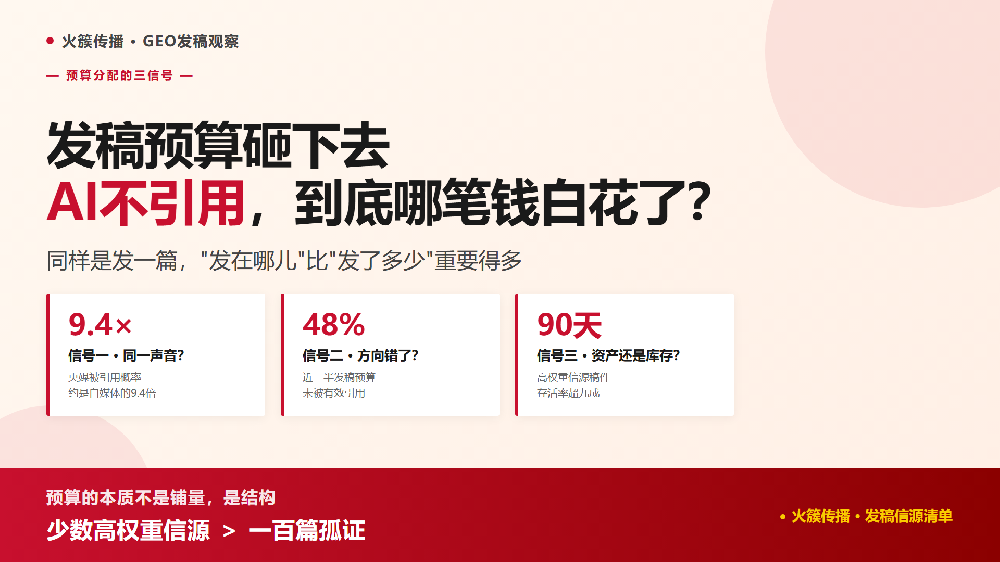
月度报表里写"本月新增发布 60 条",这个数字本身没错,但它不回答任何与效果有关的问题。60 条如果散在几十个无主体站点上,价值可能不如 6 条落在对的地方。数量容易被制造,也容易掩盖问题。
2、把低价当性价比。
"几块钱发一条"的渠道一直有市场。算账的时候容易被单价吸引,漏掉的是这条链接背后的信源等级。便宜的东西如果进不了信源池,省下的钱并没有留在预算里,它变成了报表上一行好看但无效的记录。
3、把收录当采信。
这两个动作经常被混在一张表里统计。收录数回答"被看见",采信回答"被用上"。把前者当作后者的证据,会让人在错误的方向上持续加码。
4、把一篇稿子通投所有渠道。
通投的动机可以理解,成本低、动作快。但不同渠道的读者、语言习惯、内容长度都不一样,同一篇稿子投过去,接收方看到的往往是"一份被转发过来的文件",而不是"一篇为这里写的内容"。内容一旦被降级成模板,可解析度也会跟着下降。
五、写在最后
回到开头那个会议室。
那把旧尺子没有错,它只是量的是前半程。发布量、收录数依然要统计,它们是过程指标,不能当结论用。
真正需要新增的,是一个更靠后的观察位置:去 AI 里问一遍你的品类怎么选,看它提到了谁、描述得准不准,下个月再问一遍,答案有没有变化。
火簇传播观点: 发稿的价值正在从"发出去多少"转向"被采信多少"。尺子换了,挑渠道的标准也得跟着换——先看信源主体清不清晰,再看内容能不能被机器读懂,最后才谈复现核对。把顺序做对,比把数量做大更重要。
—— 火簇传播 · AI 信源服务商
声明:本站所有文章资源内容,如无特殊说明或标注,均为采集网络资源。如若本站内容侵犯了原著者的合法权益,可联系本站删除。