火簇・AI 观察|发稿选媒体,智能搜索手里有一份你不知道的"信源清单"
收录率是搜索引擎时代的考核指标,智能搜索时代选媒体,看的不是"能不能收录",而是"在不在智能搜索的那份清单上"。
这两件事听起来像一回事,其实差得很远。
火簇传播 · AI 信源服务商
一、一个让很多人意外的事实
先看一组公开数据。
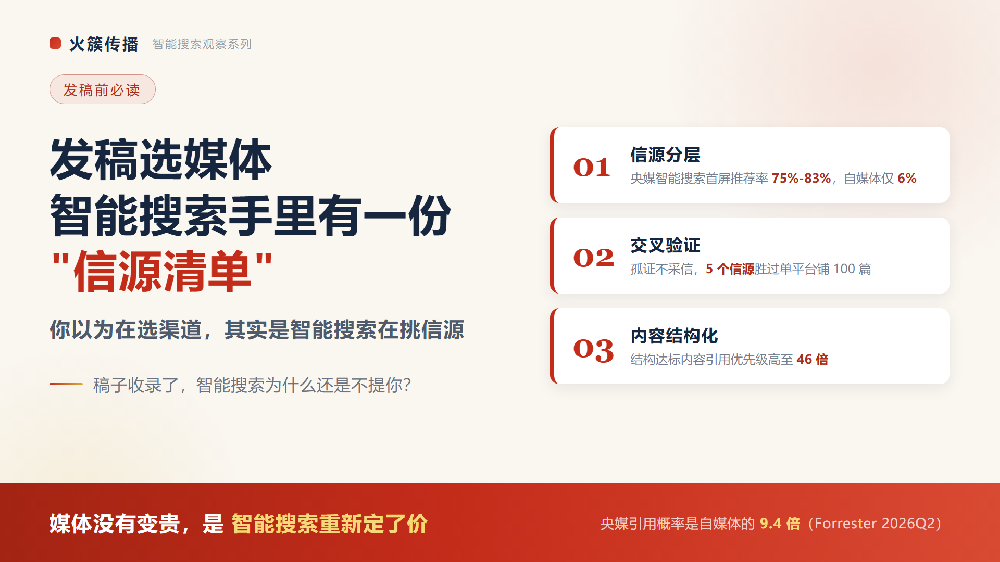
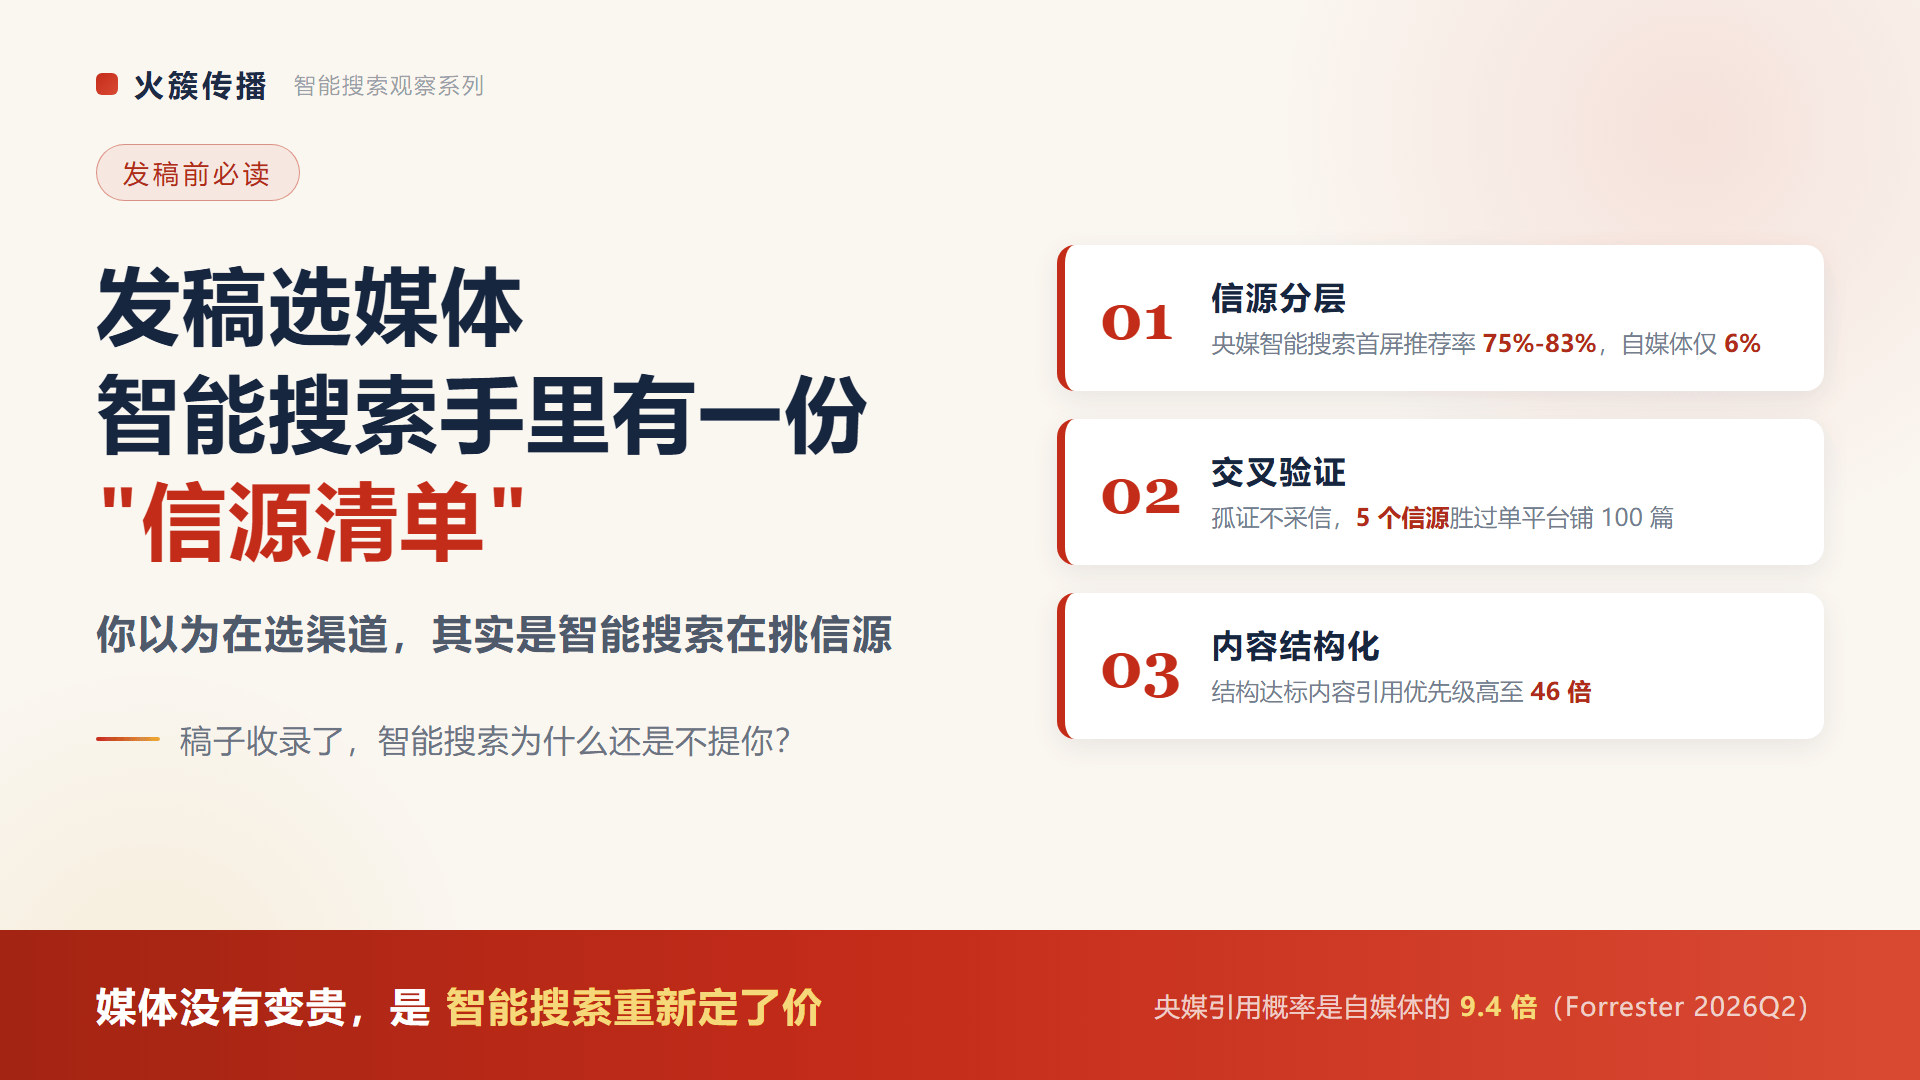
据中国广告协会2026年发布的一份品牌信源建设白皮书,不同层级媒体在智能搜索首屏的推荐率大致是这样的:央媒重点频道75%-83%,省级重点媒体43%-57%,市级官媒29%-40%,商业门户约18%,自媒体平台约6%。
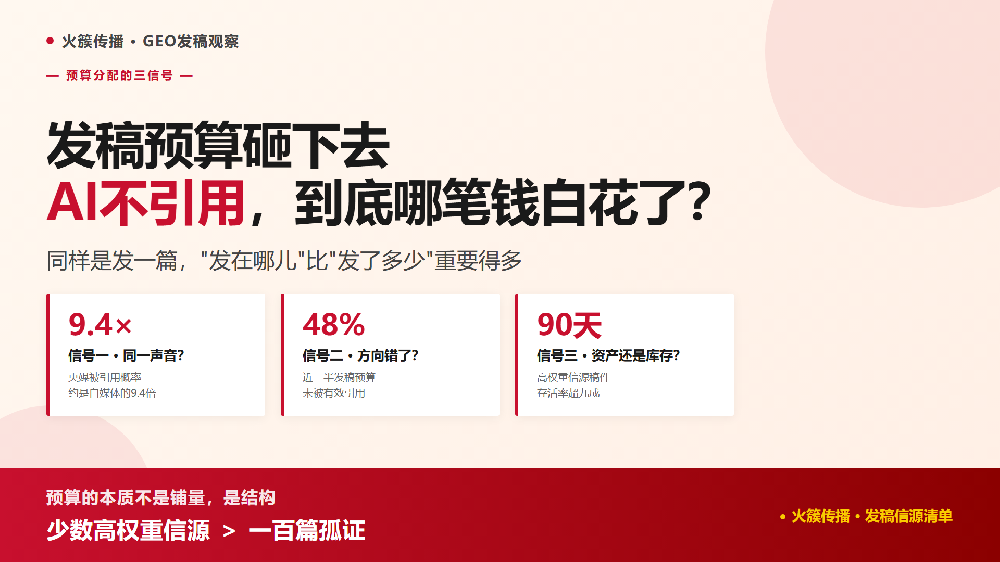
再据Forrester 2026年Q2报告,央媒内容被智能搜索引用的概率,是普通自媒体的约9.4倍。
同一篇稿子,发在不同的媒体上,智能搜索对它的态度是两个世界。
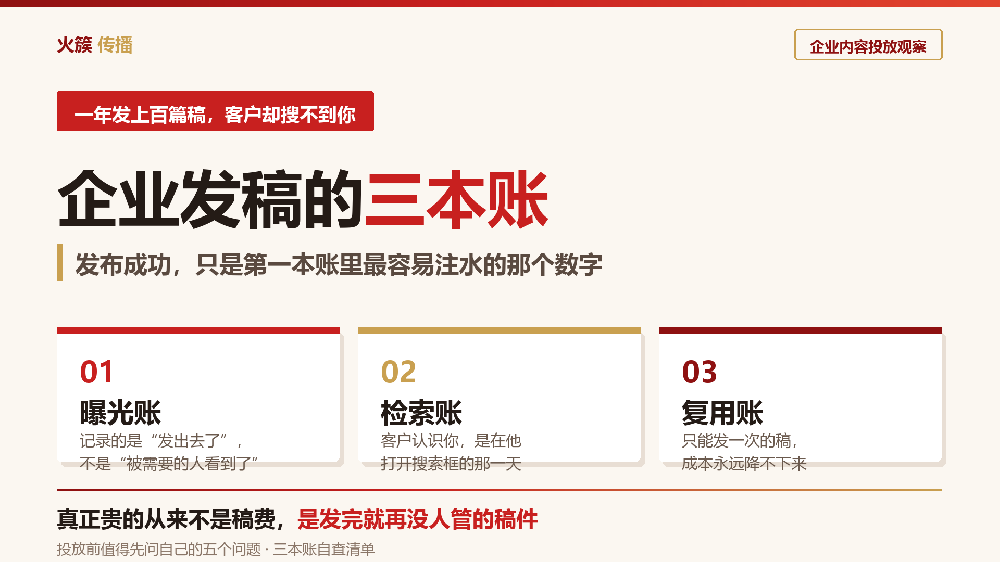
很多企业的发稿逻辑还停留在三年前:写一篇稿,找个发稿平台,"全网分发"几十上百个站,然后看后台收录截图,齐活。
收录截图确实好看。问题是,你的客户已经不搜了,他们改问了。
据行业调研,2026年问答式搜索的使用占比已经超过传统搜索引擎。采购商想知道"哪家供应商靠谱",打开的是豆包、DeepSeek、元宝这类问答工具,不是搜索框。问答结果里没有你,收录一万条也等于零。
这里有一个多数人没想过的视角转换:你以为自己在挑发稿渠道,实际上,是智能搜索在挑它的信源。 你的媒体清单,本质上是在帮智能搜索决定"要不要信你"。
二、智能搜索不是不看媒体,是只看"信源分层"
大模型对信源不是一视同仁的,它内部有一套类似"分层采信"的机制。综合多家机构的公开披露,这个分层大致是:
官方信源:政府官网、权威标准文件,事实类问题的首选;
权威媒体:央级媒体、重点新闻网站,商业话题里智能搜索优先采信的头部梯队;
主流与垂直媒体:省级官媒、门户新闻、行业头部媒体,做交叉验证的中间层;
自媒体与UGC:提供讨论视角,单独引用的概率很低;
低质采集站:基本被过滤,发了约等于没发。
几个数据点值得留意(均来自公开报道,供参考):
据行业实测披露,在商业品牌类话题中,豆包对权威媒体信源的采信概率是普通自媒体的约6.8倍,是低质站点的20倍以上;
当权威信源和自媒体信源在同一事实上"打架"时,九成以上的情况下,大模型采信权威那一方;
央媒域名在主流中文大模型中的权威度评分均值在90分上下,普通商业媒体60分左右,个人自媒体只有30多分。
这意味着什么?一篇稿子被"收录",只说明它进了搜索引擎的库;它有没有进智能搜索的采信池,取决于发在哪个层级。 低层级站点的稿子,收录了也大概率躺在池子外面。
三、比层级更要紧的一条逻辑:智能搜索不信"孤证"
如果说信源分层决定了"资格",那交叉验证机制决定了"信任"。
行业里流传一句话:孤证不采信。 这是当前大模型采信机制的通则——据公开披露,智能搜索对确定性结论普遍要求多个独立信源交叉验证,单篇内容在单个问答结果中的引用占比也很有限。
把这个机制想透,很多传统发稿做法就直接失效了:
单平台海量铺量:同一个内容源发100篇,在智能搜索看来只是"一个声音",交叉验证凑不够数;
全网一键分发同一篇稿:内容完全相同、发布时间一致、来源批量雷同,反而容易被判定为批量营销内容;
只发一次就等结果:信源没沉淀、验证没凑齐,自然等不来引用。
反过来,行业观察显示,在几个不同类型的高权重平台发布口径一致的信息,形成"多方证实"的信号,比单平台铺量有效得多。 这就是为什么有从业者形容:发稿进入了"少而精、多而准"的时代——数量换了维度,从"发多少篇"变成了"几个独立信源在替你说话"。
四、选媒体的四个自查维度
说了这么多机制,落到"下次选媒体时怎么判断",我把它整理成四个自查维度。不是操作手册,是发稿前拿着清单问自己的问题——具体怎么落地,各家企业情况不同,但判断逻辑是共通的。
维度一:这个媒体在智能搜索的哪一层?
别问"收录率多少",问"它属于哪个信源层级"。判断依据很朴素:它是官方背景、持牌媒体,还是商业门户、个人号?有没有稳定的采编团队和内容把关?低质站点的特征也很明显——批量采集、内容农场式的更新、搜索引擎里搜域名都搜不出什么历史。层级差一位,智能搜索的采信态度差一个量级。
维度二:发布之后,有几个独立信源替你说话?
发稿前值得先想清楚这次投放的"验证结构":这次发布之后,关于这件事,智能搜索能在几个互相独立的来源里看到一致的信息?如果答案还是"就这一篇",孤证困境没有解决。这也解释了为什么比"发100篇同稿"更合理的思路,是少数几个不同类型的高权重信源,各发一条口径一致的信息。
维度三:稿子本身,智能搜索"读得懂"吗?
信源层级是外部条件,内容是内部条件。大模型解析内容不是人类的"阅读理解",而是语义抽取——据海外生成式搜索优化领域的基准研究,结构化程度高的内容,引用表现可以比散文式内容高出数倍。自查起来不复杂:核心结论有没有前置?关键信息是具体数据还是形容词堆砌?有没有清晰的小标题、列表、问答结构? 满篇"行业领先""匠心品质"的稿子,发在央媒上,智能搜索也提取不出什么。
维度四:这次投放是"一次性消费"还是"信源资产"?
据行业观察,面向智能搜索的发稿,生效周期通常以周计(常见说法是4-9周),但信源一旦沉淀,内容的生命周期可以很长——有披露称高权重信源的稿件90天存活率超过九成,生命周期以年计。所以选媒体时值得多问一句:这个渠道上的内容,三个月后还在吗?半年后再被检索时还找得到吗? 采集站和内容农场的稿件,"存活期"可能只有几周。
五、几个高频疑问,说点实在的
问:那是不是全部预算砸央媒就行?
也不是。央媒贵、门槛高、未必适合所有内容。多家平台的公开建议是"分层组合"——权威媒体做背书、垂直媒体做专业绑定、地方站做区域补充,具体比例各家说法不一,仅作参考。更值得记住的是行业调研里的那个数字:艾瑞2026年Q1对1200家企业的调研显示,48%的品牌方因为稿件不符合智能搜索的采信标准,发布后未被有效引用——钱花了,位置错了。
问:垂直媒体权重不如央媒,还有必要发吗?
有。智能搜索回答专业问题时偏爱垂直信源,垂直媒体的引用率并不低(据Forrester报告,专业领域引用率可达40%-50%)。背书靠权威,专业靠垂直,两类信源解决的是不同问题。
问:自媒体号还有用吗?
有,但角色变了。自媒体在智能搜索的采信体系里主要是"讨论热度"的补充,指望它单独撑起引用不现实(引用率普遍低于10%-15%)。它的价值在于让品牌话题"有人在说",而不是"替你背书"。
六、写在最后
回头看开头那组数据:央媒首屏推荐率75%-83%,自媒体6%。中间隔着十倍以上的差距。
但我不认为这是个"小玩家没戏"的故事。信源分层是公开信息,交叉验证是公开信息,结构化偏好也是公开信息——牌面透明,认真研究的人总有机会。 真正的风险是拿着上个时代的地图,找这个时代的路:钱花了不少,稿子发了不少,智能搜索的答案里始终没有你。
下次拿到一份发稿方案,别先看报价单,先问一句:这些媒体,在智能搜索的清单上吗?
火簇观点: 媒体没有变贵,是智能搜索重新定了价。同样是发一篇稿,落在智能搜索的采信池里是资产,落在池子外面就是库存。选媒体之前,先看清单,再看价格,顺序不能反。
—— 火簇传播 · AI 信源服务商
声明:本站所有文章资源内容,如无特殊说明或标注,均为采集网络资源。如若本站内容侵犯了原著者的合法权益,可联系本站删除。