火簇・科技观察|AI 推荐名单只有三五个位置,美容仪品牌卡在哪三关
一个品牌市场负责人,把「家用某频美容仪推荐」分别问了三个 AI。
回答都很像样:先讲技术路线的区别,再讲不同肤质的适配。答完,列了四个名字。
四个名字里,没有他家的。
他盯着屏幕看了一会儿,脑子里冒出来的第一个判断是:我们的稿子是不是发得不够多?
这个判断大概率是错的。原因不在数量上——AI 给出的名单,本来就只有这么长。
一、那里没有第三页
做惯了搜索的人,脑子里有一套位置感:一个关键词下排着上百个结果,翻到第五页都还有人看;排在第三十名不算好,但它至少是「在」的。
AI 把这件事改了。它不给一个能往下翻的列表,它给一段话,里面提到几个名字,然后结束。没有第一页第二页,也没有第三十位。
这意味着两件事。一件是难度:你不再是跟一百个结果比高低,而是在争几个提名位。
另一件更关键:落选和排名靠后,是两种完全不同的处境。 排名靠后的人还在场上;没进名单,你在这条问题下就是不存在的——而且没有任何提示会告诉用户「其实还有别的品牌」。
所以这不是名次问题,是入场问题。
二、名单有多短:三份研究落在同一个区间
「只有三五个」不是感觉,是被测出来的。
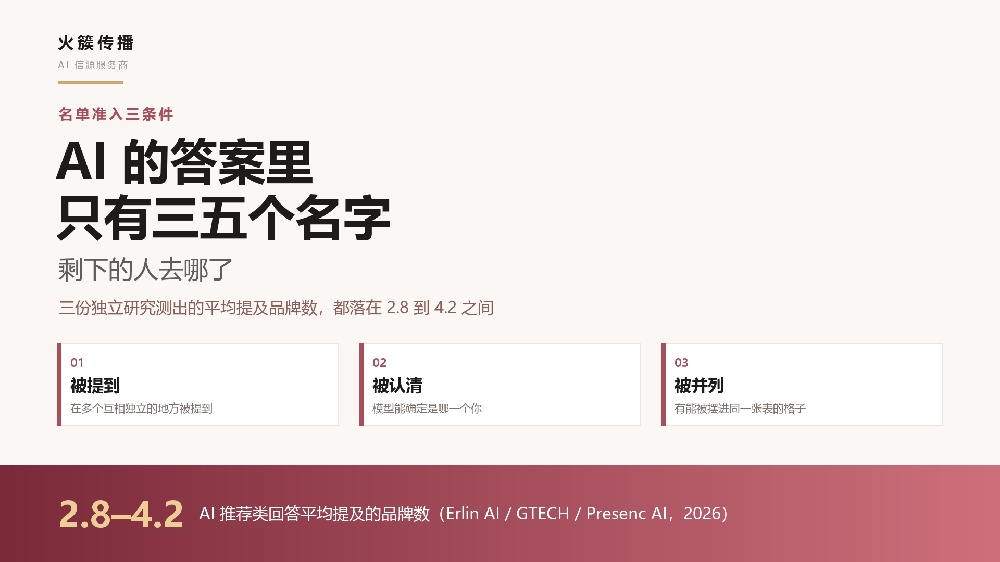
2026 年,三份来自不同团队的独立研究分别统计了 AI 在推荐类回答里平均提到多少个品牌:
· Erlin AI 分析 15,000 多条购买意图提问,平均 2.8 个;
· GTECH 用 1,200 条商业意图提问跑 ChatGPT、Gemini、Claude,平均 3.4 个;
· Presenc AI 的样本更大——50,400 条回答、18 个行业、2,400 多个品牌,平均 4.2 个。
三组数字落在 2.8 到 4.2 之间。这就是「AI 推荐名单」的长度。
这三份研究来自不同团队,样本和方法各不相同,数字只能说明量级和方向。
名单长度还会跟着问题类型变。同样问美容仪,问「推荐几款」,答案里通常在 4 个上下;问「A 和 B 哪个更适合我」,名单缩到 2 到 3 个;问「这个品类里有哪些值得看的」,位置反而多些,能到 5 到 7 个。
这一条有用:不同的问题,位置数量不一样。 你未必只能在最短的那类问题里挤。
三、位次之间的落差更陡
名单内部也不是平的。
Presenc AI 在同一个研究里还测了一件事:被排在第一个的品牌,吸引了用户后续追问的 38%;排在第四位之后的只有 6%。差了六倍多。
也就是说,「进名单」只是第一关,名单内部还有一道很陡的落差。
另一组数字来自 GTECH:22% 被 AI 提到过的品牌,在传统搜索里连首页都排不进去。
两组数据放在一起,说的是同一件事:AI 的名单和搜索的排名,是两套独立的评价方式。花在旧指标上的力气,不会自动变成新名单里的位置。
四、名单准入三条件
那模型凭什么挑这几个名字?
先把它做的事说清楚:模型不做排名。它做的是从一个巨大的语料池里,挑出几个它有把握的名字。
「有把握」具体表现为三个条件。
条件一:被提到。
听起来像废话,真正的含义在后半句——要在多个互相独立的地方被提到。
同一个事实,只出现在你自己的官网、旗舰店、企业号里,对模型来说它是一条主张;在行业报道、第三方测评、公开商品信息、技术讨论里反复出现,它才是一条能被拿来用的信息。
对美容仪来说,这里有个需要自查的问题:你投出去的内容,是不是都长在自己家的地里?
条件二:被认清。
模型要确定,说的这个「你」是哪一个你。
美容仪在这点上吃亏得很具体:品牌名相近的多,系列名和型号的命名又杂,同一款产品在旗舰店、达人视频、用户笔记里可能有三四种叫法。消费者提问时用简称,模型未必接得住,它可能先撞上了名字相近的另一个品牌。
被认清的前提是收敛:一个产品一个写法,所有渠道一个写法。
条件三:被并列。
前两条决定你能不能被写进答案,第三条决定你能不能被写进比较型的答案。
消费者问「哪款更适合我」时,模型需要有能被并排放置的对象。参数、能量输出方式、控温机制、单次使用时长、机身重量、适用肤质区间——这些是能被摆进同一张表的格子。
反过来,「很好用」「用了都说好」「技术领先」这类说法撑不起并列,因为它们没有任何一个可以对齐的格子。
三个条件有先后:先存在,再确认,再比较。前一条没过,后一条不成立。
五、在美容仪这个品类,名单压得更紧
一,赛道本身高度集中。 据飞瓜数据 2026 年美妆线上消费洞察,2025 年美护仪器的头部集中特征非常明显:排名居首的品牌市占率约 28.5%,前五名合计已经过半。
而内容资源的分配——达人合作、行业媒体选题、平台推荐位——天然向已经集中的那几个名字倾斜。集中还会自我强化:越集中,第三方内容越多;第三方内容越多,模型越容易挑中他们。
二,消费者的提问偏向「比较」。 她很少问「有哪些品牌」,更多问「射频和微电流差在哪」「这个价位哪款更适合敏感肌」。而比较型提问,恰好是所有问题类型里名单最短的一类。
三,名单不是铁板一块。 行业研究里能看到,有品牌用两年时间把细分赛道的市占率从不到 4% 提到 11% 以上。放在「只有三五个位置」的背景下,这个例子说明的不是「谁都能挤进去」,而是名单的构成一直在被重新决定。
六、六个可以先自查的维度
照例说明:以下是自查维度,不是执行方案。不同价位、不同技术路线差别很大,照搬容易走偏。
1、名单基线——用客户的口吻问几个 AI,把答案里的名字记下来。先有基线,才谈得上变化。
2、提及的分布——关于你的公开内容里,多少是别人写的,多少是自己发的?比例失衡,第一个条件就过不去。
3、名称的收敛度——同一款产品在官网、旗舰店、内容渠道、用户口中有几种叫法;客户用简称提问,模型能不能落到你身上。
4、可并列的维度——你能被摆进一张比较表的格子有几个;产品介绍里,形容词占多大比例。
5、名单的变动——同一个问题隔一个月再问一次,名单变了多少。这是判断「位置能不能拿」最直接的办法。
6、信息的时效——产品迭代后,第三方位置的描述有没有跟上。
七、几个会被问到的问题
问:我们投放量不小,为什么还是不在名单里?
投放买的是触达,名单看的是可核对的信息。这两件事不冲突,但不同源。一条内容被很多人看到,和一条内容能被模型当依据使用,中间隔着一个「可核对性」。
问:是不是内容发得越多越好?
不是。同一个说法重复一百遍,对模型来说仍然只是一个来源。它需要的是在不同的、互相独立的地方,看到能对得上的同一件事。
问:多久能进名单?
品类竞争密度和现有信息基础差别很大,没有统一答案。可以确定的是名单本身在动,所以动作做对了,位置会被腾出来。任何把周期说得很确切的说法,都值得留个心眼。
八、名单是活的,这一点对你是好消息
回到开头那个问题:剩下的人去哪了?
他们大多没有去哪,只是还没凑齐被挑中的条件。
这个判断有依据。GTECH 在两轮复测里发现:47% 的 AI 回答,在一个月内就换了品牌名单。
另一项重复测试更极端——同一个问题问一百遍,能稳定出现在八成以上回答里的,只有大约 5 个名字,而这些名字只占全部被提到品牌的 11%。
两个数字合起来是这么一张图:名单的短,是硬的;名单的动,也是真的。
短,意味着没进名单时确实什么都不会发生。动,意味着它不是一扇已经关上的门——绝大多数位置,隔一段时间就会被重新决定一次。
火簇传播观点: 名单的长度很难变,名单的构成一直在变。三五个位置不会变多,但它们每隔一段时间就会被重新决定一次。你能做的是让机器在下一次决定时,找得到你、认得出你、比得了你。
—— 火簇传播 · AI 信源服务商
声明:本站所有文章资源内容,如无特殊说明或标注,均为采集网络资源。如若本站内容侵犯了原著者的合法权益,可联系本站删除。